基准测试工具之你不知道的两三事 | 12. 单机测试与集群测试有什么不同
基准测试工具之你不知道的两三事 | 12. 单机测试与集群测试有什么不同
前面的文章中,我们已经讨论了怎样验证正确性、比较接口和寻找合理的并发区间。接下来把数据库从单机换成集群,是不是只要增加节点,再把客户端数乘几倍就可以了?
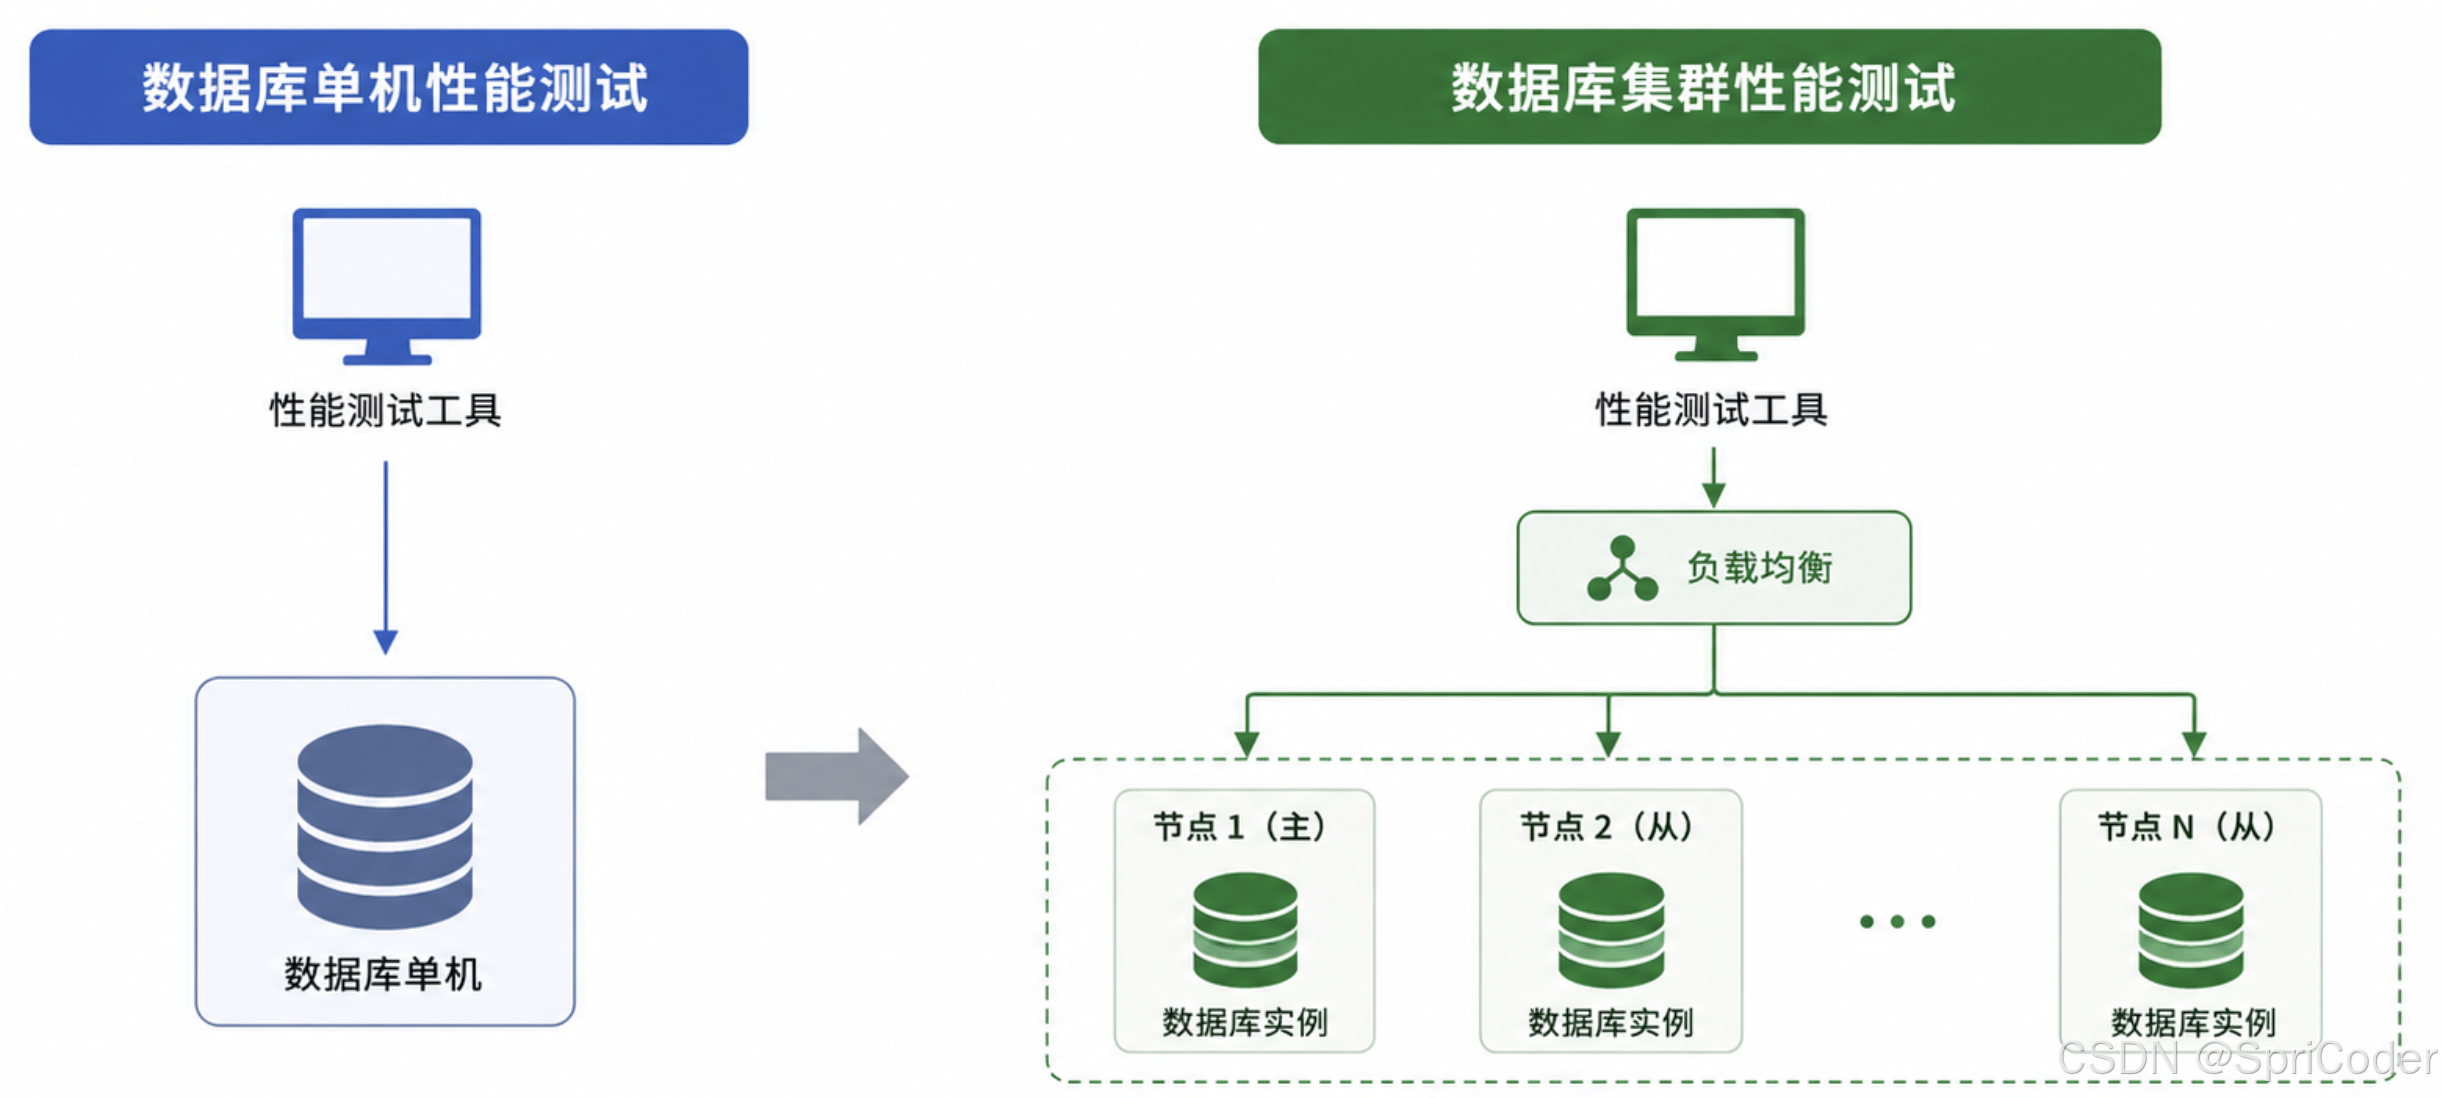
并不是。单机测试主要观察一台服务器上的 CPU、内存、磁盘和数据库执行路径;集群测试还会引入网络、请求路由、数据分片、副本写入和节点间负载均衡。此时,测试结果不仅由数据库“单节点有多快”决定,也取决于数据和请求是否真的分散到了多个节点。
更容易混淆的是,IoT Benchmark 配置中的“Benchmark 集群模式”指的是多个压测工具实例协同发压,并不等于待测数据库已经部署成集群。
1. 先分清两种“集群”
| 概念 | 被扩展的对象 | 主要目的 | 不能自动保证什么 |
|---|---|---|---|
| 数据库集群 | 数据库服务端节点 | 扩展容量、吞吐、可用性或副本能力 | 请求一定均匀、容量一定线性增长。 |
| Benchmark 多实例 | 压测客户端进程或机器 | 避免单个客户端成为瓶颈,产生更大或更分散的压力 | 数据库已经负载均衡、结果已经自动汇总。 |
两者可以自由组合:单个 Benchmark 实例测试单机数据库;单个 Benchmark 实例测试数据库集群;多个 Benchmark 实例测试数据库集群;甚至多个实例共同测试一个单机数据库,用来确认客户端是否曾是瓶颈。
图中左侧实例是否真的打到不同服务端节点,取决于数据库驱动、访问入口和路由策略,不能仅凭“启动了三个 Benchmark”推断。
2. 单机测试和集群测试回答的问题不同
单机测试适合建立基础能力边界:在固定硬件、固定数据和固定负载下,一个数据库实例的吞吐量、P99 和资源消耗处于什么范围。它更容易控制变量,也更适合发现版本退化和接口差异。
集群测试则要回答另一组问题:增加节点后容量能否扩展,请求和数据是否均衡,网络与副本带来多少额外代价,以及某个热点是否会让部分节点先达到瓶颈。
| 测试问题 | 更适合的部署 | 需要额外观察的证据 |
|---|---|---|
| 新版本的单节点写入路径是否退化 | 单机 | 单机 CPU、磁盘、内存、吞吐和尾延迟。 |
| 三个节点能否承载更大的总负载 | 集群 | 每节点资源、路由分布、分片分布和总吞吐。 |
| 增加节点能否降低同一负载下的延迟 | 单机基线 + 集群对照 | 固定总负载下的 P99 与集群内部开销。 |
| 热门设备持续写入时是否出现热点 | 集群 | 设备到分片的映射、各节点请求量和磁盘写入量。 |
| 节点异常是否影响连续服务 | 独立的故障实验 | 故障注入时间、失败窗口、恢复时间和数据正确性。 |
因此,“单机每秒处理多少点”和“集群每秒处理多少点”通常不能直接放在一起排名。前者是单实例能力,后者混入了节点数、网络和分布策略。
3. IoT Benchmark 的多实例模式做了什么
在当前代码版本中,多实例模式由以下两个参数控制:
1 | |
当 BENCHMARK_CLUSTER=true 时,工具会按下面的关系计算当前实例的首个设备编号:
1 | |
假设每个实例配置 DEVICE_NUMBER=1000,设备区间会形成如下映射:
这样做的核心作用,是避免多个 Benchmark 实例默认生成相同设备名,导致不同客户端向同一批设备和时间序列写入。这个偏移也会被 schema 和查询工作负载使用,使每个实例围绕自己的设备区间工作。
但这两个参数不会替你完成以下工作:
- 不会创建或启动数据库集群;
- 不会配置数据库的分片、副本和负载均衡;
- 不会检查各客户端机器的时钟是否一致;
- 不会自动判断所有实例是否同时开始、同时结束;
- 不会把多台机器上的结果自动解释成一个可信的集群结论。
所以,多实例模式解决的是设备编号隔离,而完整的分布式压测仍需要额外的启动编排、监控和结果汇总。
4. 集群测试不能只把客户端数乘倍数
如果单个 Benchmark 实例已经把所在机器的 CPU 或网络跑满,继续增加客户端线程可能只是在测试压测机。反过来,如果直接启动多个实例,却没有检查数据库节点分布,也可能出现所有请求都经由同一入口、落到同一个热点节点的情况。
一轮可靠的集群测试至少包含四层检查:
| 层次 | 需要检查什么 | 常见异常 |
|---|---|---|
| 客户端 | 客户端 CPU、网络、GC、连接数和生成数据速度 | 数据库还有余量,但发压端已经到顶。 |
| 接入与网络 | 目标地址、连接分布、客户端到节点的网络时延 | 所有连接集中到一个入口或跨区域链路。 |
| 数据分布 | 设备、时间分区、分片和副本的实际归属 | 设备名不同,但分片仍集中在少数节点。 |
| 服务端 | 每节点请求量、CPU、内存、磁盘与网络 | 总体看似正常,某个节点已成为热点。 |
| 结果 | 各实例成功点数、失败数、P99 与正确性证据 | 汇总吞吐升高,但部分实例持续失败。 |
只有这几层证据能够互相对应,才可以说测试覆盖了数据库集群,而不是“几台客户端同时运行”。
5. 两种常见的扩展性测试口径
比较单机和集群时,至少应区分两种实验。
5.1 固定总负载:观察集群额外开销与余量
保持总设备数、总写入速率、操作比例和数据量不变,只改变数据库部署方式。这个实验适合回答:相同业务负载从单机迁移到集群后,延迟、资源和稳定性如何变化。
由于集群可能引入网络和副本开销,总吞吐不一定自动提高;但单节点资源压力可能下降,并获得更多容量或可用性余量。
5.2 随节点数增加负载:观察扩展效率
分别测试 1、2、3……个服务端节点,并按预先约定增加总设备数或目标速率。每个规模下都要重新确认客户端不是瓶颈、数据分布均衡且正确性通过。
可以用下面的比值辅助描述扩展情况:
1 | |
它只是当前环境下的观察指标,不是越接近 100% 就一定越好。副本数、网络拓扑、存储介质和一致性要求不同,都会改变合理范围。真正的结论仍应同时包含 P99、失败数、每节点资源与正确性。
6. 一份多实例配置示意
假设使用三台压测机,每台负责相同数量但不同编号的设备,可以分别准备三份配置。除实例编号、客户端本机地址等必要差异外,其余工作负载应保持一致。
1 | |
运行前还应建立一张映射表:
| 实例 | BENCHMARK_INDEX |
设备区间 | 数据库入口 | 结果文件 | 状态 |
|---|---|---|---|---|---|
| client-0 | 0 | 0—999 | 待填 | 待填 | 待测 |
| client-1 | 1 | 1000—1999 | 待填 | 待填 | 待测 |
| client-2 | 2 | 2000—2999 | 待填 | 待填 | 待测 |
表中的结果文件必须分别保留。汇总时先逐实例检查失败数和 P99,再计算成功点数与总运行时间口径一致的聚合结果,不能简单相加各自打印的 point/s 而忽略开始、结束时间差。
7. 五个常见误区
第一,把 BENCHMARK_CLUSTER=true 当作数据库集群开关。它只改变 Benchmark 的多实例设备编号逻辑。
第二,多个实例使用相同 BENCHMARK_INDEX。这会造成设备区间重叠,测试语义随之改变。
第三,只看集群总 CPU。总量会掩盖单节点热点,应始终保留每节点数据。
第四,把节点数增加等同于性能线性增长。路由、网络、副本和分片都可能限制扩展效率。
第五,直接相加不同时间窗口的吞吐量。聚合结果必须基于统一的有效运行窗口和成功点数口径。
8. 小结
单机测试用于建立清晰、可控的基础能力;集群测试则要额外验证客户端、网络、路由、分片、副本和节点均衡。IoT Benchmark 的 BENCHMARK_CLUSTER 与 BENCHMARK_INDEX 可以让多个压测实例使用不同设备区间,但不会自动完成数据库集群部署、流量均衡和结果复盘。
开始集群测试前,可以用三个问题自查:
- 我扩展的是数据库节点、Benchmark 实例,还是两者同时扩展?
- 数据与请求是否有证据表明确实分布到了多个节点?
- 聚合结论是否同时包含正确性、尾延迟、失败数和每节点资源?
把这三件事说清楚,集群测试才不只是“机器更多了”。下一篇将讨论怎样保存一轮测试的配置、日志、结果和环境,使异常能够被复盘、结论能够被重现。
系列文章
- 第一篇:数据库基准测试工具是什么
- 第二篇:从一次时序数据库写入测试开始
- 第三篇:如何模拟线上写入负载
- 第四篇:如何读懂测试结果波动
- 第五篇:什么是读写混合负载
- 第六篇:如何模拟线上读写混合负载
- 第七篇:怎样做一场公平的性能对比
- 第八篇:怎样找到并发与批大小的合理区间
- 第九篇:如何模拟乱序写入
- 第十篇:不同写入接口该怎样比较
- 第十一篇:性能测试与正确性验证有什么区别
- 第十二篇:单机测试与集群测试有什么不同
- 第十三篇:怎样保存和复盘一轮测试
- 第十四篇:一份可复用的基准测试方案模板