基准测试工具之你不知道的两三事 | 10. 不同写入接口该怎样比较
基准测试工具之你不知道的两三事 | 10. 不同写入接口该怎样比较
同一套数据库,可能同时提供 JDBC、REST、Session 等多种写入接口。它们看起来只是“换一条调用路径”,实际却可能经过不同的序列化方式、连接管理策略和批处理实现。
因此,比较接口并不是为了给它们排一个绝对名次,而是回答一个更具体的问题:在同一份数据、同一种写入语义和同一套资源条件下,哪种接口更适合当前业务的目标?
这一篇以 IoT Benchmark 为例,讨论如何让接口比较既公平,又对工程选型有用。
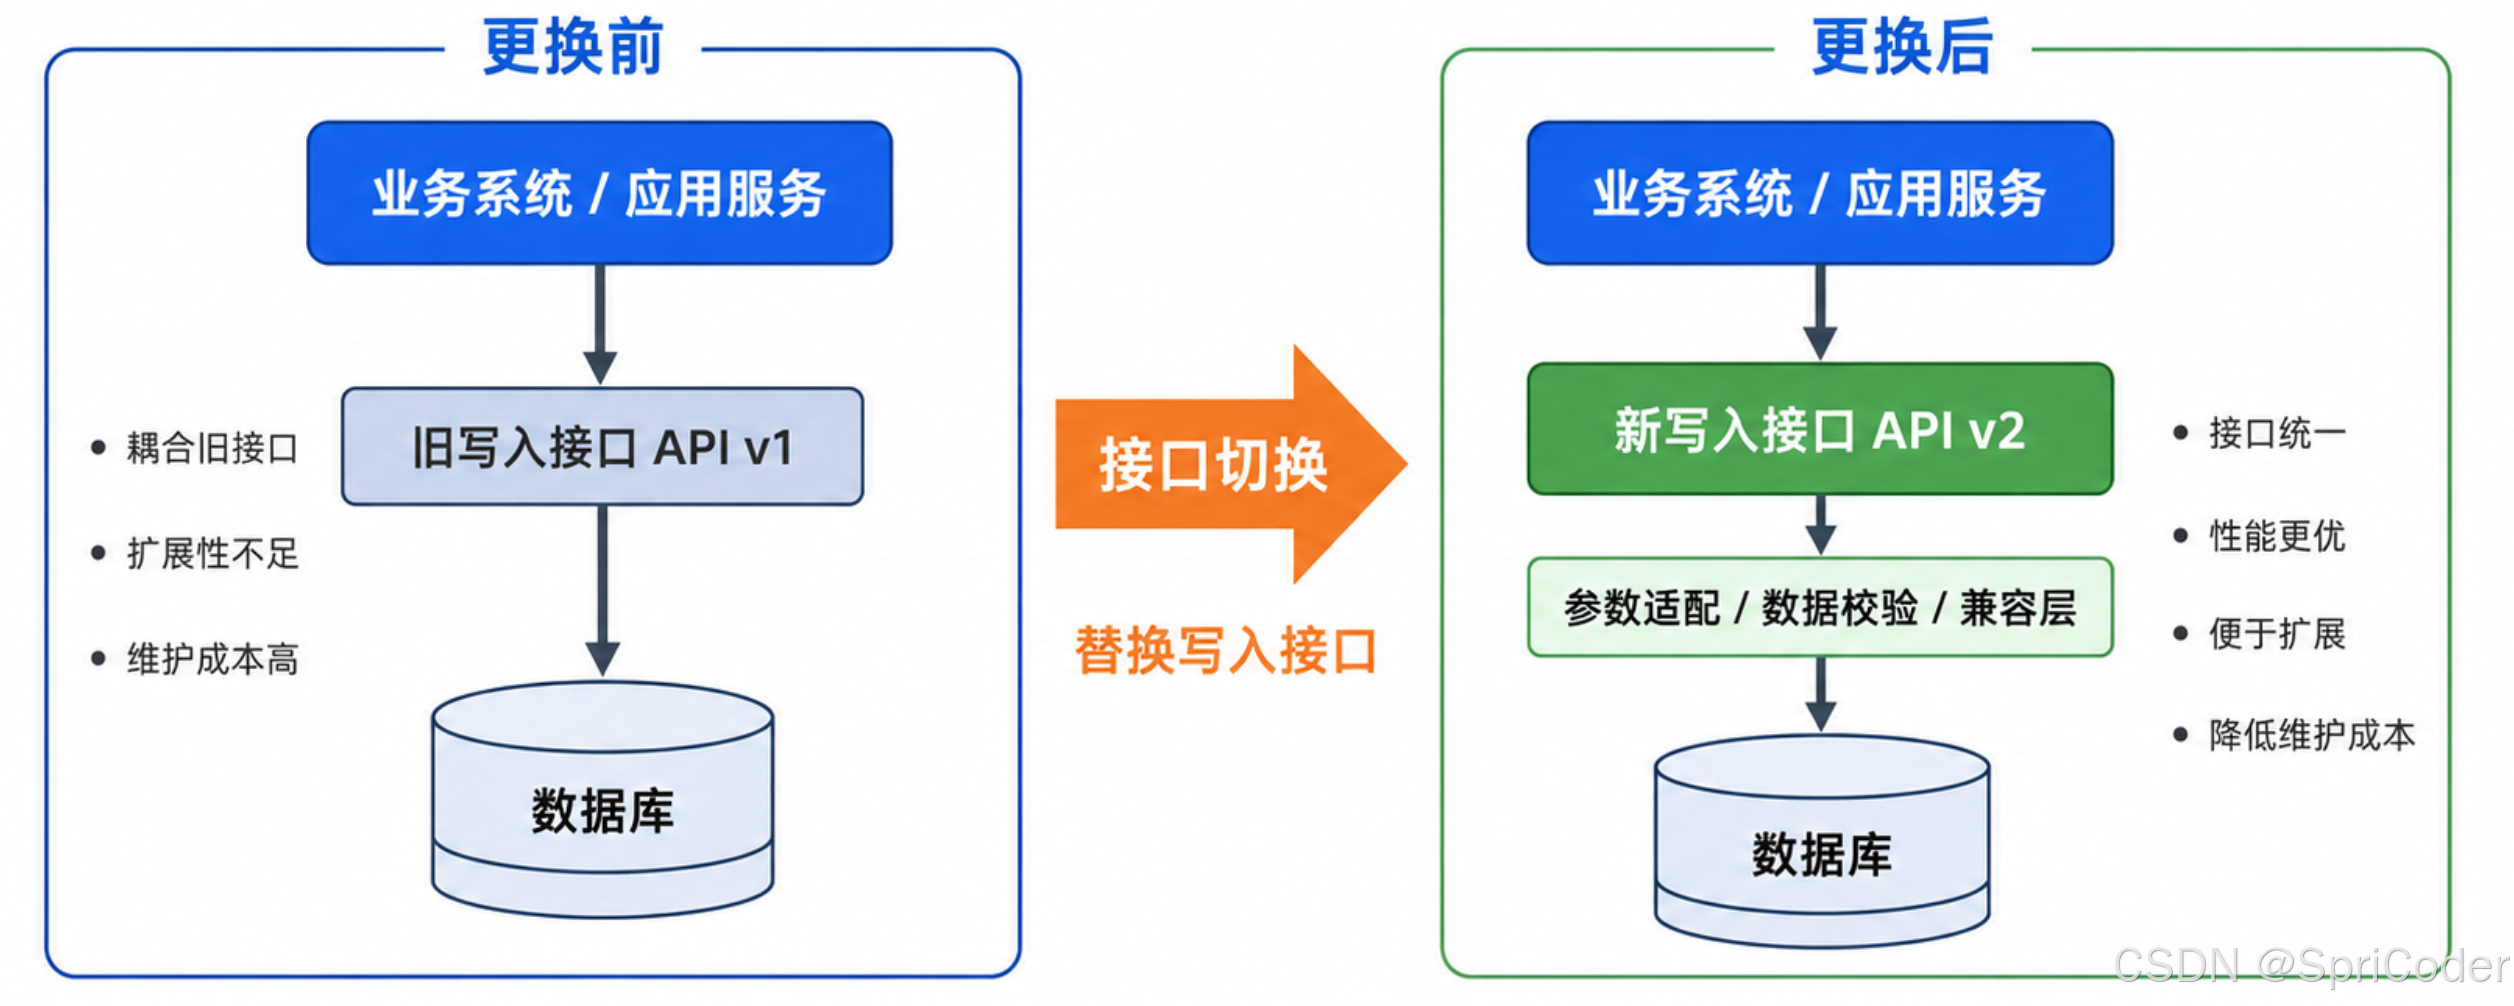
1. 先明确:你比较的是接口,不是两套测试
如果 JDBC 使用 10 个客户端、每次写 100 行,而 REST 使用 20 个客户端、每次写 1 000 行,最后比较两个吞吐量,得到的并不是接口差异,而是两套负载的差异。
接口比较的核心是控制变量。可以把一轮测试拆成两部分:
| 应保持一致的内容 | 可以随接口变化的内容 |
|---|---|
| 数据库版本、部署拓扑、数据模型、设备数、测点数、时间戳规则、写入总量、客户端数、批大小、压测时长 | 协议与驱动、请求编码、连接建立方式、接口原生支持的写入调用 |
右侧这些变化正是接口实现的一部分,应当被记录,而不应被假装“抹平”。例如,一个接口原生支持按 Tablet 批量写入,另一个接口以 HTTP 请求承载批数据;二者的封装路径不同,结果自然可能不同。公平的要求不是让它们内部完全一样,而是让它们面对同一业务工作量。
2. “同一工作量”到底要固定什么
接口对比最容易漏掉的,是只固定了记录条数,却没有固定一条记录真正包含什么。建议把以下内容写入测试方案,并在每次运行时复核。
| 维度 | 需要固定的内容 | 为什么重要 |
|---|---|---|
| 数据模型 | 设备数、每设备测点数、数据类型、标签或路径结构 | 不同 schema 会改变元数据处理与写入放大。 |
| 数据内容 | 时间范围、时间戳精度、顺序 / 乱序比例、空值与异常值规则 | 数据分布不同,存储和编码路径也可能不同。 |
| 写入语义 | 每条记录、每设备、每批所代表的数据量;是否要求幂等 | “一次请求”不应成为比较单位,逻辑数据量才是。 |
| 到达负载 | 客户端数、批大小、写入间隔、持续时间与预热策略 | 这些参数会直接改变连接和服务端排队压力。 |
| 环境 | 服务端版本与配置、节点规模、硬件、网络、客户端机器 | 环境漂移会掩盖接口本身的差异。 |
一个实用原则是:以成功写入的数据点数或逻辑记录数作为工作量单位,而不是以“请求数”作为唯一单位。同样 1 万条数据,10 个大请求与 1 万个小请求对接口的压力完全不同。
3. 用 IoT Benchmark 切换接口,但不要顺手改动负载
IoT Benchmark 通过 DB_SWITCH 选择待测数据库及连接方式。以官方 README 中列出的 IoTDB 2.x 配置为例,可选择 IoTDB-200-JDBC、IoTDB-200-REST、IoTDB-200-SESSION_BY_TABLET、IoTDB-200-SESSION_BY_RECORD 或 IoTDB-200-SESSION_BY_RECORDS 等不同写入路径。
这给接口对比提供了一个清晰的起点:每次只变更 DB_SWITCH 对应的接口,其余负载参数保持不变。 例如,设备规模、DATA_CLIENT_NUMBER、每次写入涉及的设备数、BATCH_SIZE_PER_WRITE 和写入间隔,都应来自同一份基线配置。
1 | |
这里的“保持不变”有一个边界:如果某个接口根本不支持某种批写语义,不能通过额外的业务层拼装去强行模拟,再宣称是在比较原生接口。应该如实记录该接口能力边界,并把比较问题改写为“在相同逻辑工作量下的可用实现”,而不是假装所有接口具备完全相同的调用模型。
4. 先比较两个层次,再解释结果
单独给出峰值吞吐量,往往不够回答工程问题。更有用的做法是同时给出“接口效率”和“线上代价”两个层次。
| 层次 | 建议观察项 | 回答的问题 |
|---|---|---|
| 接口效率 | 成功写入吞吐量、平均 / P99 延迟、失败率 | 在固定负载下,这条接口路径能处理多少数据、是否稳定。 |
| 客户端代价 | 客户端 CPU、内存、连接数、网络流量 | 更高的吞吐是否依赖更重的编码、更多连接或更多带宽。 |
| 服务端代价 | CPU、内存、磁盘、网络、后台任务与错误日志 | 性能差异来自接口侧,还是已经把服务端某项资源打满。 |
| 使用边界 | 超时、重试、鉴权、错误可观测性与 SDK 成熟度 | 这条接口能否满足实际开发和运维要求。 |
比如,接口 A 的吞吐量略高,但在同一客户端资源下 P99 大幅波动;接口 B 的吞吐略低,却有更稳定的失败率和更清楚的错误反馈。前者不一定就是更好的线上选择。性能结论与工程选择应并列呈现,而不是互相替代。
5. 推荐的执行顺序:从可用到可比
在正式压测前,每个接口都应先通过一个最小可用性检查:能否连接、能否建模、能否写入预期数据,以及写入结果能否被查询到。只有这些条件成立,后续的性能数字才有意义。
随机或交替运行的目的,是减少时间因素带来的偏差。若总是先跑 JDBC、后跑 REST,后一次可能已经受到了缓存、磁盘状态、后台合并或环境温度变化的影响。更稳妥的方式是轮换顺序,并让每个接口都有足够的重复轮次。
6. 一张结果表,不要只放一个 TPS
下面是一份可直接用于汇报的结果表结构。表中的数值必须来自真实运行;不要把示例配置或 README 输出当作实测结论。
| 接口 | 数据库与驱动版本 | 逻辑工作量 | 吞吐量 | P99 延迟 | 失败率 | 客户端 / 服务端资源 | 结论边界 |
|---|---|---|---|---|---|---|---|
| JDBC | 待填 | 待填 | 待填 | 待填 | 待填 | 待填 | 待填 |
| REST | 待填 | 待填 | 待填 | 待填 | 待填 | 待填 | 待填 |
| Session | 待填 | 待填 | 待填 | 待填 | 待填 | 待填 | 待填 |
“结论边界”这一列尤其重要。它至少要说明:该结论适用于什么数据模型、什么批大小和并发区间,以及是否包含乱序或读写混合。这样,读者才不会把一个特定条件下的结果外推为所有场景的定论。
7. 三个常见误区
第一,把批大小调到各接口各自的最高点再比较。这适合回答“各接口各自的最佳实践是什么”,却不适合回答“在相同业务批次下谁更快”。两种问题都值得测试,但不能混在同一张排名表里。
第二,只看客户端报告的吞吐量。客户端发得很快,不等于服务端已经稳定接收。必须同时检查失败数、超时、服务端日志和必要的结果校验。
第三,忽略建连与预热阶段。短时任务中,连接建立、鉴权和首次请求可能占主要成本;长期稳定写入中,它们的占比又可能很低。报告应说明统计窗口是否包含这些阶段。
8. 小结
比较 JDBC、REST、Session 等写入接口,关键不在于得到一个“万能第一名”,而在于固定逻辑工作量和环境,把协议与调用方式作为唯一主动变量,并同时记录吞吐、延迟、失败和资源代价。
当结果带有明确的版本、数据模型、批大小、并发和统计窗口时,接口对比才会从一次跑分,变成可以指导 SDK 选择与系统设计的工程证据。下一篇将讨论另一个常被忽略的问题:性能测试跑得快,是否就代表数据真的写对了?
系列文章
- 第一篇:数据库基准测试工具是什么
- 第二篇:从一次时序数据库写入测试开始
- 第三篇:如何模拟线上写入负载
- 第四篇:如何读懂测试结果波动
- 第五篇:什么是读写混合负载
- 第六篇:如何模拟线上读写混合负载
- 第七篇:怎样做一场公平的性能对比
- 第八篇:怎样找到并发与批大小的合理区间
- 第九篇:如何模拟乱序写入
- 第十篇:不同写入接口该怎样比较
- 第十一篇:性能测试与正确性验证有什么区别
- 第十二篇:单机测试与集群测试有什么不同
- 第十三篇:怎样保存和复盘一轮测试
- 第十四篇:一份可复用的基准测试方案模板