基准测试工具之你不知道的两三事 | 6.如何模拟线上读写混合负载
基准测试工具之你不知道的两三事 | 6.如何模拟线上读写混合负载
上一篇文章中,我们介绍了读写混合负载为何不能只看纯写或纯读结果;在此之前,我们已经跑通了写入测试,并把线上设备的上报节奏、批写、乱序和峰值翻译成了写入负载。
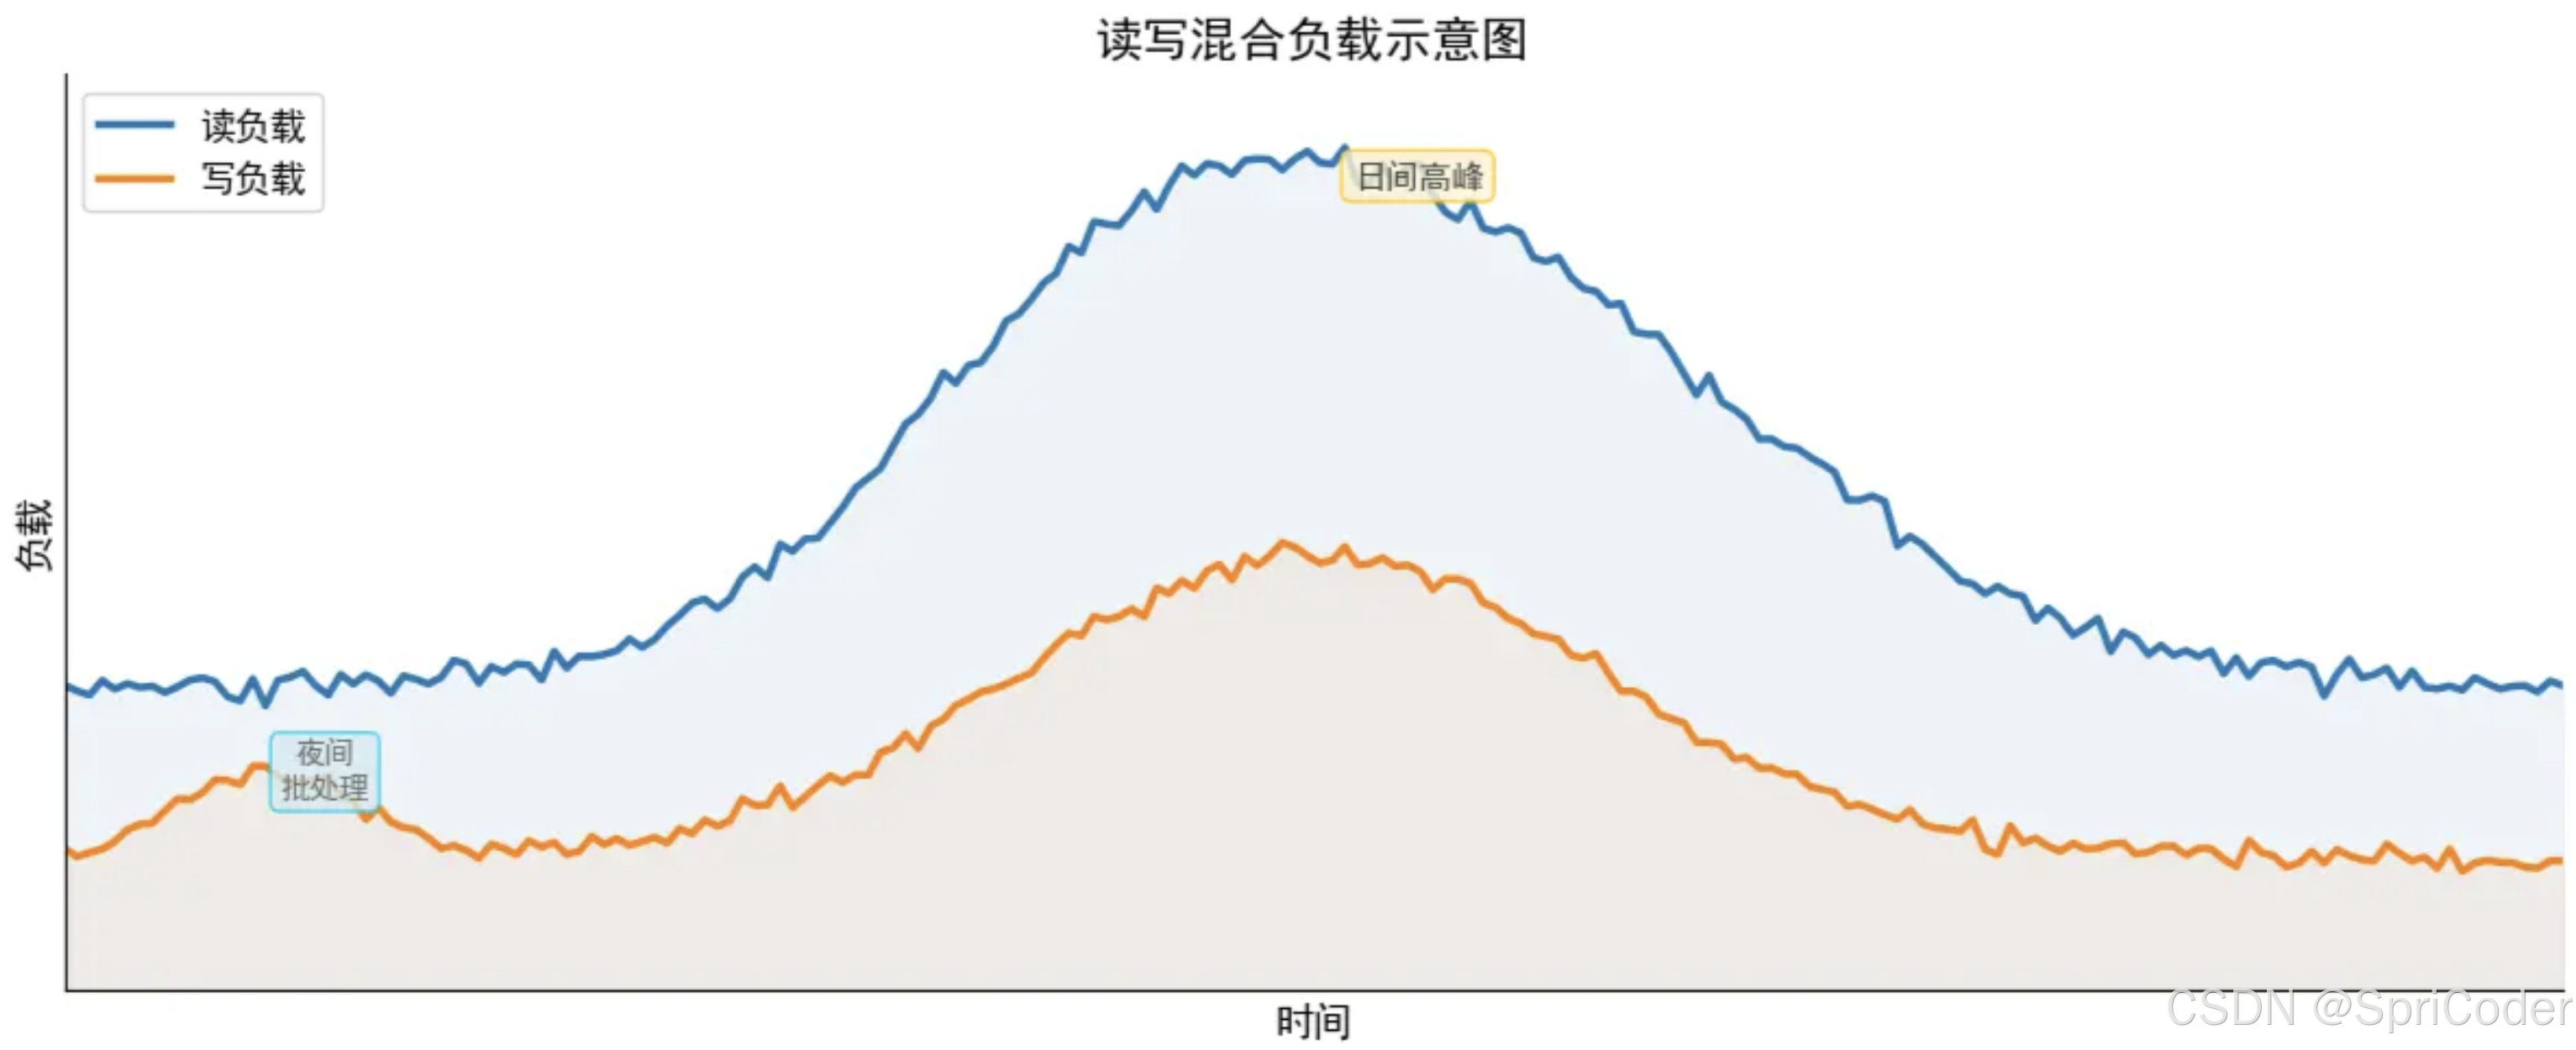
但真实系统往往不会在写入时完全停止读取。设备持续上报的同时,仪表盘要刷新最新状态,值班人员会查看一段时间内的趋势,告警服务也可能触发聚合统计。此时,只测纯写入已经不足以回答“线上运行是否流畅”。
这一篇继续使用 IoT Benchmark,讨论怎样从纯写基线出发,逐步构造一份可解释的读写混合负载。
1. 先想清楚:写入时,谁在读什么?
读写混合负载的难点不在于“加几个查询”,而在于读请求本身可能完全不同。查看设备最新状态、展示过去一小时曲线、统计当天平均值,虽然都叫“查询”,但对数据库施加的压力并不一样。
在配置前,先用业务语言回答下面三个问题:
- 谁在读:是少量运维人员、固定仪表盘,还是大量终端用户?
- 读什么:是一个设备的最新点、一个时间范围,还是带聚合的统计结果?
- 读多频繁:是每秒刷新,还是告警触发后偶尔回溯?
只有这三个问题有了答案,读操作比例和查询时间范围才有明确的来路。
图中的三类读请求不必同时出现。一次测试只应保留业务中确实存在、且当前希望评估的那几类操作。
2. 用 OPERATION_PROPORTION 组织操作比例
IoT Benchmark 的常规模式 testWithDefaultPath 支持读写混合。核心配置项是 OPERATION_PROPORTION:它用一串以英文冒号分隔的整数,定义写入与各类查询操作的相对比例。
当前默认配置的顺序为:
1 | |
其中,Q1 是精确点查询,Q2 是按时间范围查询,Q4 是带时间条件的聚合查询,Q8 是最近点查询;其余位置对应带值过滤、分组、倒序或集合操作等查询。具体查询类型和支持范围应以当前 config.properties 及目标数据库模块的说明为准。
例如,下面的配置并不是性能推荐值,而是表达一种业务假设:四份写入操作对应一份精确点查询、一份时间聚合查询和一份最近点查询。
1 | |
比例表达的是相对构成,不是“每秒必须执行几次”。真正的到达节奏还会受到客户端数量、批写大小和操作间隔等设置影响。因此,在文章或报告中应同时记录比例、并发和时间参数,而不能只写一串比例数字。
3. 十三种操作分别在模拟什么?
OPERATION_PROPORTION 中的每一个位置都对应一种明确操作。写入操作和 Q1-Q12 加起来一共 13 项;不需要全部启用,但应知道每一项在模拟什么,才能正确选择比例。
| 位置 | 操作 | 操作含义 | 更贴近的线上场景 |
|---|---|---|---|
| 第 1 项 | 写入 | 向数据库写入生成的时序数据 | 设备、网关或应用持续上报。 |
| Q1 | 精确点查询 | 查询指定设备在某个时间点的数据 | 点击某时刻的数据点,或核对单条采样。 |
| Q2 | 时间范围查询 | 只按起止时间过滤的范围查询 | 展示某设备最近一小时或一天的趋势。 |
| Q3 | 带值过滤的范围查询 | 在时间范围内再按数值条件过滤 | 查找温度超过阈值的历史记录。 |
| Q4 | 带时间条件的聚合查询 | 在一个时间范围内计算聚合结果 | 统计某时段的平均值、最大值或计数。 |
| Q5 | 带值过滤的聚合查询 | 对满足数值条件的数据进行聚合 | 统计超过阈值的数据量。 |
| Q6 | 带时间和值过滤的聚合查询 | 同时限制时间范围和数值条件后聚合 | 统计某个班次内的异常指标。 |
| Q7 | 分组聚合查询 | 按时间窗口分组后聚合 | 把原始数据降采样后绘制趋势图。 |
| Q8 | 最近点查询 | 获取某设备最新的时间和值 | 实时状态卡片、设备在线概览。 |
| Q9 | 倒序范围查询 | 按时间倒序返回一个时间范围的数据 | 页面优先展示最新的历史事件。 |
| Q10 | 倒序带值过滤的范围查询 | 倒序返回满足数值条件的数据 | 优先查看最近发生的异常记录。 |
| Q11 | 倒序分组聚合查询 | 按时间窗口聚合后倒序返回 | 从最新窗口开始查看统计趋势。 |
| Q12 | 集合操作查询 | 将多个范围查询用 union 等集合操作组合 |
对多个条件或多个时间窗口的结果做集合运算。 |
当前配置注释还标出了部分限制:Q11 目前仅支持 IoTDB、TDengine 3.0 和 InfluxDB v1;Q12 当前仅支持 IoTDB 2.0 的表模型。其他操作是否支持,也应在测试前查看目标数据库模块的说明。
初次构造混合负载时,通常优先从 Q8、Q2 和 Q4 中选择:它们分别覆盖“看最新状态”“看一段趋势”和“看一段统计”三类常见需求。Q3、Q5、Q6、Q9-Q12 更适合业务确实有阈值筛选、倒序浏览或集合计算时再单独加入。
例如,下面两组比例都只表达场景,不代表通用推荐值:
1 | |
如果业务同时既要看状态又要看趋势,不要马上叠加所有操作。建议先分别运行“写入 + Q8”和“写入 + Q2”,确认每类查询的影响后,再设计包含两者的组合负载。
4. 新近数据与历史数据,要分开设计
线上仪表盘常常关心刚刚写入的数据。IoT Benchmark 提供了 IS_RECENT_QUERY 参数:在读写混合场景下开启后,查询会优先落在最近写入数据附近。
1 | |
这适合模拟“设备正在上报,页面同时刷新”的场景。但它不等于所有业务查询都应该读取最新数据。历史趋势分析、班次报表或事故回溯,往往会访问更早的时间范围;若把它们都混进“最近数据”测试,结果反而失去业务含义。
可以按查询目标把场景分成两类:
| 线上行为 | 更贴近的查询设计 | 需要重点观察 |
|---|---|---|
| 设备状态卡片持续刷新 | 最近点查询或最近数据附近的查询 | 写入是否仍稳定,最新读是否出现明显尾延迟。 |
| 趋势图展示一段时间曲线 | 时间范围查询 | 查询范围增大后,是否影响写入吞吐和 P99。 |
| 告警后查看统计摘要 | 带时间条件的聚合查询 | 聚合请求出现时,写入和查询是否都保持可接受延迟。 |
| 离线报表或历史回溯 | 单独设计历史读负载 | 不要把低频重查询误当成实时面板请求。 |
QUERY_DEVICE_NUM、QUERY_SENSOR_NUM、QUERY_INTERVAL 等参数用来继续描述查询涉及多少设备、多少测点和多长的时间范围。它们应来自页面实际一次会展示多少设备和多长窗口,而不是为了“把查询压大”随意填写。
5. 从纯写基线,逐步加入查询
读写混合最稳妥的设计方式,不是从一开始就同时开启多种查询,而是把纯写负载作为基线,再逐步加入一类读操作。
例如,可以先保持写入的设备数、客户端数、批大小和乱序比例不变,只把 OPERATION_PROPORTION 从纯写改为“写入 + 最近点查询”。确认这一步的写入吞吐、写入 P99、查询 P99 和失败数后,再考虑加入时间范围或聚合查询。
这样的顺序有两个好处:第一,性能变化更容易归因;第二,若某个查询类型并不被目标数据库模块支持,可以尽早发现,而不会把“功能不支持”和“性能下降”混在一起。
6. 结果矩阵应按操作类型分别阅读
混合负载结束后,IoT Benchmark 会分别列出写入和各类查询操作的成功数、失败数、吞吐量与延迟统计。读结果时,不能把所有行合并成一个总分。
| 观察到的情况 | 应怎样理解 |
|---|---|
| 写入吞吐下降,但查询延迟稳定 | 查询可能已开始与写入争用资源;先与纯写基线比较下降幅度。 |
| 写入稳定,但某类查询 P99 很高 | 说明在线写入未必受影响,但该查询形态可能不适合当前配置。 |
| 写入和查询都出现失败 | 先检查连接、配置、操作支持与超时,再讨论性能。 |
| 最近数据查询稳定,范围查询波动很大 | 不应把两类查询合并评价;它们访问的数据量和路径不同。 |
| 总吞吐提高,但写入行或查询行的失败数不为 0 | 这轮不能作为“性能更好”的结论依据。 |
特别是在读写混合时,写入吞吐量的下降并不天然是坏事。它可能反映了系统在为真实读请求分配资源。真正需要回答的是:在业务可接受的读延迟下,写入能力还剩多少;反过来,在写入不退化到不可接受的前提下,查询是否足够及时。
7. 三个常见误区
第一,把读写比例当成业务本身。4:1:0:0:1... 只是对业务行为的编码,不是一个通用最佳比例。比例改变前,应能说清楚对应多少用户、多少页面或多少告警任务。
第二,一轮测试同时混入所有查询类型。精确点、范围、聚合、倒序和集合查询的代价不同。刚开始就全部混入,只会让结果很热闹,却很难知道是哪个操作带来变化。
第三,忽略目标数据库的操作支持范围。IoT Benchmark 文档明确提示,不同数据库模块未必支持 OPERATION_PROPORTION 中的每一种操作。配置前应检查目标模块说明;若某种操作不支持,不能把失败数误解为系统性能不足。
8. 小结
模拟线上读写混合负载,真正要做的是把“谁在写、谁在读、读什么、读多频繁”翻译成一份可以验证的配置。开始时不妨只选择一种最典型的读请求,并以纯写测试作为对照。
在提交一份混合负载结果前,可以再检查一次:
- 写入负载是否仍与纯写基线保持一致?
- 每一种查询是否都有对应的线上行为?
OPERATION_PROPORTION中启用的操作是否被目标数据库模块支持?- 是否分别记录了写入和各类查询的吞吐量、P99 与失败数?
- 当结果变化时,是否能够回到配置、日志和资源状态寻找证据?
完成这些检查后,读写混合测试就不再只是“给纯写测试加一点查询”,而能更接近线上系统真正同时面对的压力。下一篇可以继续讨论:当两个数据库版本或两种写入接口都能跑通同一份负载时,怎样做一场更公平的性能对比。
系列文章
- 第一篇:数据库基准测试工具是什么
- 第二篇:从一次时序数据库写入测试开始
- 第三篇:如何模拟线上写入负载
- 第四篇:如何读懂测试结果波动
- 第五篇:什么是读写混合负载
- 第六篇:如何模拟线上读写混合负载
- 第七篇:怎样做一场公平的性能对比
- 第八篇:怎样找到并发与批大小的合理区间
- 第九篇:如何模拟乱序写入
- 第十篇:不同写入接口该怎样比较
- 第十一篇:性能测试与正确性验证有什么区别
- 第十二篇:单机测试与集群测试有什么不同
- 第十三篇:怎样保存和复盘一轮测试
- 第十四篇:一份可复用的基准测试方案模板