基准测试工具之你不知道的两三事 | 3.如何模拟线上写入负载
基准测试工具之你不知道的两三事 | 3.如何模拟线上写入负载
上一篇文章里,我们已经跑通了一次 IoT Benchmark 的默认写入测试,并学会了从吞吐量、失败数和 P99 延迟中读出一轮测试的基本情况。
不过,默认配置只能证明工具能够运行,不能自动代表你的业务。现实中的设备有多少?每个设备有多少测点?数据是稳定上报还是集中补传?一条请求会写入多少行?这些问题不先回答,再精确的测试也只是在测一份陌生的负载。
这一篇继续使用 IoT Benchmark,讨论写入工作负载:怎样把业务中的设备、上报节奏和补传行为翻译成一份可执行、可解释的配置。
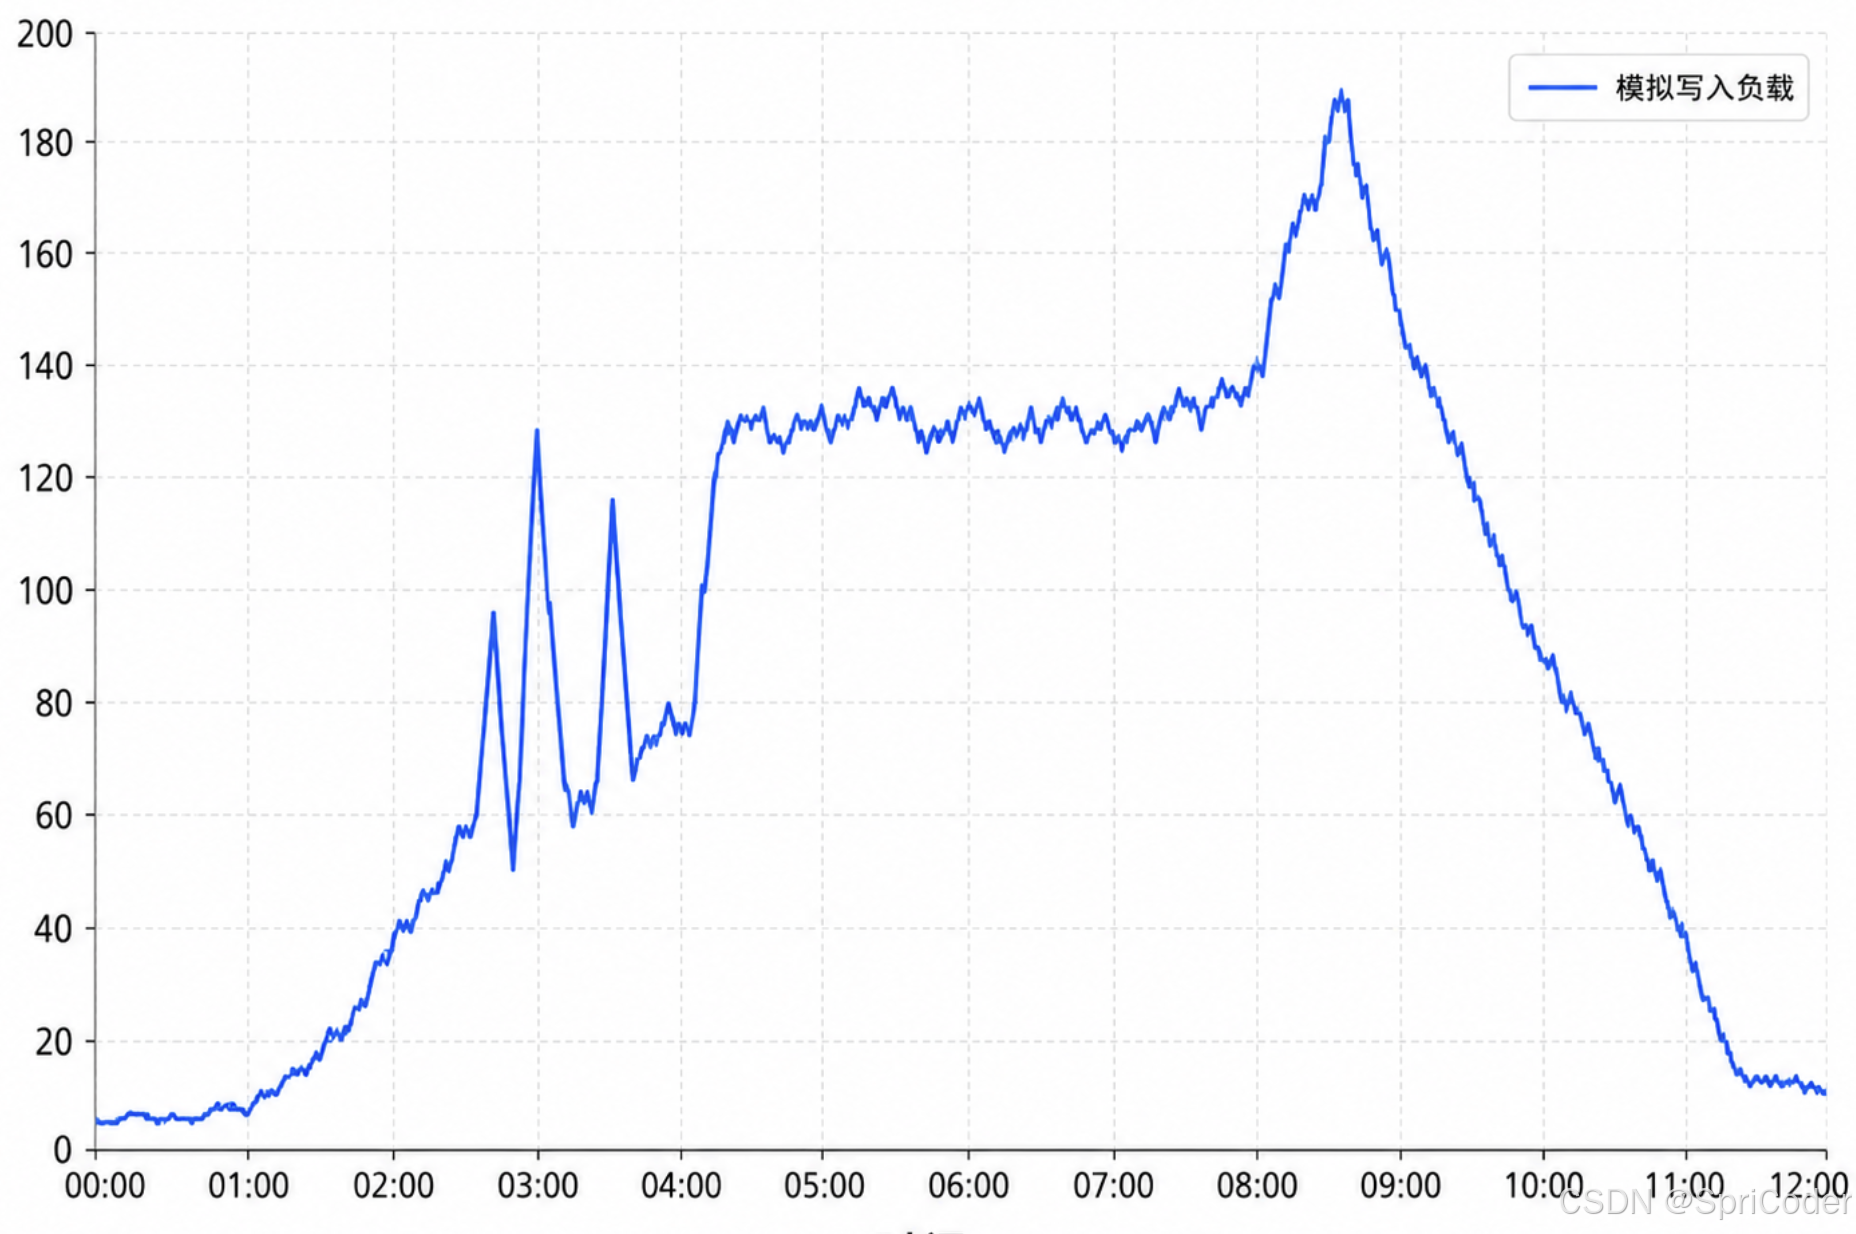
1. 工作负载不是“把参数调大”
很多人第一次调基准测试,会先想到把设备数、并发数和循环次数都调大。这样做当然可能把系统压到更高负载,但它回答的往往只是“在这组极限参数下能跑多快”,而不是“在我的业务里会怎样”。
写入工作负载设计的核心不是制造一个最大的数字,而是让测试里的写入行为和业务里的上报行为能一一对应。它至少应说明四件事:
- 谁在产生数据:设备数量、每台设备的测点数量,以及是否所有设备都持续上报。
- 数据怎样到达:时间戳间隔、写入批次、客户端并发,以及是否存在补传或乱序。
- 写入的形态是什么:所有设备平稳上报,还是多个网关批量发送;是否有高峰或集中补传。
- 这轮测试想回答什么:验证持续写入能力、比较版本、观察尾部延迟,还是检查乱序数据下的稳定性。
当这四件事说清楚后,配置文件才不再是一张参数清单,而是一份可以讨论的“业务假设”。
这条链路的关键在于:结果必须能追溯到前面的业务假设,而不是只保留最后一列性能数字。
2. 先明确一句业务描述
在打开 config.properties 之前,不妨先用一句自然语言写下本轮测试的目标。例如:
模拟 500 台冷链设备,每台上报 12 个测点,每分钟一次;网络恢复后可能集中补传一小部分历史数据。
这句话还不够精确,却已经给出了工作负载最重要的骨架。接下来只需要把它拆成 IoT Benchmark 能理解的几个维度。
| 业务描述 | 常用参数 | 需要想清楚的事 |
|---|---|---|
| 有多少实体和指标 | DEVICE_NUMBER、SENSOR_NUMBER |
一台设备对应一个逻辑实体吗?不同设备的测点数量是否相同? |
| 哪些设备真的在写 | REAL_INSERT_RATE |
是所有设备持续上报,还是只有部分设备在当前时段活跃? |
| 🕒数据的逻辑时间间隔 | POINT_STEP、START_TIME |
相邻数据点在业务时间上相隔多久? |
| 请求到达的节奏 | OP_MIN_INTERVAL、DATA_CLIENT_NUMBER、BATCH_SIZE_PER_WRITE |
数据是平稳到达,还是由多个客户端批量发送? |
| 写入操作的构成 | OPERATION_PROPORTION |
本轮是否保持纯写负载,避免查询干扰写入基线? |
| 是否有迟到数据 | IS_OUT_OF_ORDER、OUT_OF_ORDER_RATIO |
现场断网、边缘缓存回传等情况是否会造成乱序? |
表中的参数不是每一轮都要修改。它的作用是提醒我们:每改一个参数,都应能说出它对应哪一种业务行为。
3. 三个容易混淆的“速度”
时序测试中常常同时出现时间间隔、客户端并发和吞吐量,它们看起来都和“快慢”有关,实际回答的却不是同一个问题。
POINT_STEP 表示生成数据的相邻时间戳间隔。把它设置为 60000,表达的是相邻数据点在业务时间上相隔一分钟;它并不等于工具会每分钟才发出一次请求。
OP_MIN_INTERVAL 才与客户端操作之间的最小间隔有关。当前配置说明中,0 表示不限制,-1 表示让该间隔与 POINT_STEP 相同。它可以帮助我们把持续写入的节奏做得更接近周期性上报,而不是让客户端尽可能快地把数据全部灌入。
DATA_CLIENT_NUMBER 和 BATCH_SIZE_PER_WRITE 则描述客户端怎样组织写入请求:前者控制参与写入的数据客户端数量,后者控制每批每个设备写入的数据行数。它们通常影响服务端看到的并发和批量大小,但不应被直接理解成“真实设备数量”。
可以把三者简单地区分为:
1 | |
把这三层混为一谈,是很多“测试结果看起来很高、却不像真实业务”的根源。
4. 从一句话到第一份配置
仍以前面的冷链设备为例。若这一轮只想先确认周期性写入的基线,可以先写成一份纯写负载:
1 | |
这不是一份“冷链行业标准配置”,也不意味着每分钟上报的设备必须这样写入。它只是把前面的业务描述明确成了一组可执行假设:500 台设备全部活跃,写入为主,没有迟到数据,客户端按固定节奏组织请求。
得到第一份配置后,最重要的动作不是立刻把并发拉高,而是确认它能否被业务同事和自己几周后的复查所解释。比如:现场设备是否真的全部在线?设备是逐台上报,还是网关会把多台设备的数据合并发送?如果答案不同,配置也应随之调整。
5. 不要忽略乱序、峰值与批写
实验室中的数据常常按时间顺序写入,生产现场却未必如此。网络中断、边缘缓存、批量补传都会让旧时间戳的数据晚于新数据到达。IoT Benchmark 通过 IS_OUT_OF_ORDER 开关乱序写入,并通过 OUT_OF_ORDER_RATIO 描述乱序数据所占的比例。
是否开启乱序,不该由“这样测试更难”决定,而应由业务是否确实存在迟到数据决定。一个合理的做法是把它单独设计成一轮测试:先记录全顺序写入的基线,再固定其余参数,只开启乱序并逐步调整比例。这样才能看清乱序到底带来了多少影响。
除了乱序,写入负载还常常有两种容易被默认配置忽略的形态:突发上报和批量导入。前者可能来自大量设备在整点同时上报,后者可能来自历史数据迁移或网关长时间离线后的集中回传。它们不能只靠“调高并发”草率模拟,而要先定义峰值来自多少客户端、持续多久、每次请求带来多少行数据。
无论测试哪一种写入形态,都应让本轮问题和配置一一对应:
| 本轮问题 | 更合适的负载思路 |
|---|---|
| 新版本写入是否退化 | 固定数据规模和环境,使用纯写负载。 |
| 断网补传是否拖慢在线写入 | 保持其余条件不变,单独开启乱序并调整其比例。 |
| 数据库是否能承受整点上报 | 固定设备规模,定义峰值客户端数、批大小与持续时间,再逐步提高写入压力。 |
| 历史数据导入是否稳定 | 保持写入操作不变,逐步扩大批大小或总循环次数,并记录失败数和尾部延迟。 |
6. 一次测试,只回答一个问题
好的基准测试不一定参数很多,但必须有清楚的对照关系。假设我们想研究批大小的影响,可以让设备数、测点数、客户端数、时间间隔、数据库版本和硬件环境保持不变,只测试 BATCH_SIZE_PER_WRITE 的几组值。这样,吞吐量或 P99 的变化才有明确归因。
反过来,若一次同时改变设备数、客户端数、批大小、乱序比例和上报节奏,即使得到一张漂亮的结果表,也很难判断究竟是哪一个因素造成差异。基准测试最常见的陷阱不是数据不够多,而是变量不够少。
在每轮开始前,可以给配置文件旁边补上三行说明:
1 | |
这三行字不会让系统跑得更快,却能让结果更有解释力。
7. 小结
用 IoT Benchmark 设计写入工作负载,并不是从参数表中挑几个看起来“够大”的值,而是把真实业务中的设备、上报节奏、批写和迟到数据逐步翻译成可复现的配置。
一份起步阶段的好配置,至少要回答下面几个问题:
- 设备和测点规模来自什么业务事实?
- 逻辑时间间隔、实际发压节奏和客户端并发是否被区分开?
- 本轮是否需要模拟乱序、补传、突发上报或批量导入?
- 这轮测试只改变了什么,又固定了什么?
- 结果能否回溯到完整的配置、环境和日志?
当工作负载有了这样的来路,吞吐量和延迟才不再只是终端里的一串数字,而能帮助我们判断数据库是否真正适合某个具体场景。下一篇我们将继续讨论:同一套负载跑出多次不同结果时,怎样读懂波动、定位瓶颈,并避免得出过早的结论。
系列文章
- 第一篇:数据库基准测试工具是什么
- 第二篇:从一次时序数据库写入测试开始
- 第三篇:如何模拟线上写入负载
- 第四篇:如何读懂测试结果波动
- 第五篇:什么是读写混合负载
- 第六篇:如何模拟线上读写混合负载
- 第七篇:怎样做一场公平的性能对比
- 第八篇:怎样找到并发与批大小的合理区间
- 第九篇:如何模拟乱序写入
- 第十篇:不同写入接口该怎样比较
- 第十一篇:性能测试与正确性验证有什么区别
- 第十二篇:单机测试与集群测试有什么不同
- 第十三篇:怎样保存和复盘一轮测试
- 第十四篇:一份可复用的基准测试方案模板